
每秒上报五次的位置事件,与每次游玩只上报一次的通关事件,需要不同的采样策略。如果两者都只保留 10%,较长的会话仍会留下不少位置记录,但那一次通关事件通过采样判断的概率也只有 10%。
事件采样按设定的概率保留每个符合条件的事件。先确定数据要回答什么问题,再为不同事件名设置保留率。对于重复的状态观测,部分数据可能已经够用;对于一次失败或到达检查点,每次发生都可能是调查所需的证据。
以下设置针对 Track 事件路径,已根据 Framedash Unity SDK 0.1.8 的实现核对。可选的逐帧 performance run 采集使用另一条路径。文中的事件量是假设计算,不是 Framedash 的实测结果,也不是适合所有游戏的推荐参数。
区分周期性观测与状态变化
为每个事件写清楚调用时机和计数含义:
player_position:按一定间隔记录位置,用于观察大致的移动模式player_death:玩家进入死亡状态时调用一次level_completed:关卡进入完成状态时调用一次
后两种事件应放在状态切换的代码中。如果生命值为零期间每帧都调用 player_death,重复记录在采样前就已产生。降低保留率只会掩盖其中一部分,无法修正事件定义。
位置上报的调用间隔要单独决定。每秒五次的计时器决定何时尝试观测,10% 的保留率再从这些观测中随机选择。经过大量调用后,平均每秒保留 0.5 条位置记录。这不等于每两秒固定保留一条,也不能保证相邻记录之间的最大时间间隔。
如果要还原一场短暂战斗中的精确路线,随机采样留下的空白可能太多。应为该问题准备限定时间范围的详细记录,或显式记录战斗开始和结束事件。提高其他事件的保留率,不会自动补上这些记录。
估算自定义事件量
假设一个 20 分钟的会话恰好调用 6,000 次位置事件、3 次死亡事件和 1 次通关事件。下表计算的是通过采样判断的预期事件数,尚未考虑缓冲、传输或摄取结果。
| 自定义事件 | 假设调用次数 | 全部保留 | 全部保留 10% | 位置保留 10%,关键事件保留 100% |
|---|---|---|---|---|
player_position | 6,000 | 6,000 | 600 | 600 |
player_death | 3 | 3 | 0.3 | 3 |
level_completed | 1 | 1 | 0.1 | 1 |
| 总计 | 6,004 | 6,004 | 600.4 | 604 |
预期值可以是小数,单次会话实际留下的数量则是整数。在独立随机采样模型下,如果这四次关键事件各以 0.1 的概率保留,一次都没有留下的概率就是 0.9^4,约 66%。在这个例子中,让这四个事件都通过采样,几乎不改变总体数量。
表中不含 SDK 内部生成的事件,也不含其他埋点。它不能用于估算账单或已送达的事件数量。实际数据量还取决于负载大小、会话时长、其他事件类型和传输结果。
初始化后设置每种事件的保留率
在 SDK 成功初始化后、游戏开始前应用策略:
using Framedash;

// Run after the project's TelemetrySDK.Initialize(...) call.
var sdk = TelemetrySDK.Instance;
sdk.SetEventSamplingRate("player_position", 0.10f);
sdk.SetEventSamplingRate("player_death", 1.0f);
sdk.SetEventSamplingRate("level_completed", 1.0f);
sdk.SetEventSamplingRate("map_load", 1.0f);
这里的名称必须与游戏实际使用的事件名一致。示例中的 player_position、player_death 和 level_completed 都由应用自行定义;设置保留率不会让 SDK 自动生成它们。map_load 则由 SDK 的地图加载上报方法生成。
Unity SDK 指南说明了按事件名覆盖采样率的方法。在 0.1.8 的采样实现中,事件级保留率会替换全局保留率。如果全局为 0.1、某事件覆盖为 1.0,该事件使用的就是 1.0,而不是两者相乘。事件名区分大小写,数值采样率会被限制在 0 到 1 之间。传入的值应为该范围内的有限数值。
全局默认值是 1.0,来自组件中序列化的采样设置,并在初始化时读取。事件种类较少时,可以保留这个默认值,只降低明确列出的高频事件,便于审核策略。未列出的新事件仍使用默认值,因此新增事件时也要检查是否意外加入了高频调用。设置与初始化代码见 TelemetrySDK.cs。
移除临时覆盖值:
sdk.RemoveEventSamplingRate("player_position");这会恢复为全局保留率,而项目中的全局值不一定是 1.0。覆盖值属于运行时状态,SDK 关闭并重新初始化后需要重新设置。修改只影响此后的采样判断,不会改变已在缓冲区中的事件,也无法恢复已丢弃的样本。
确认哪些 SDK 事件绕过采样
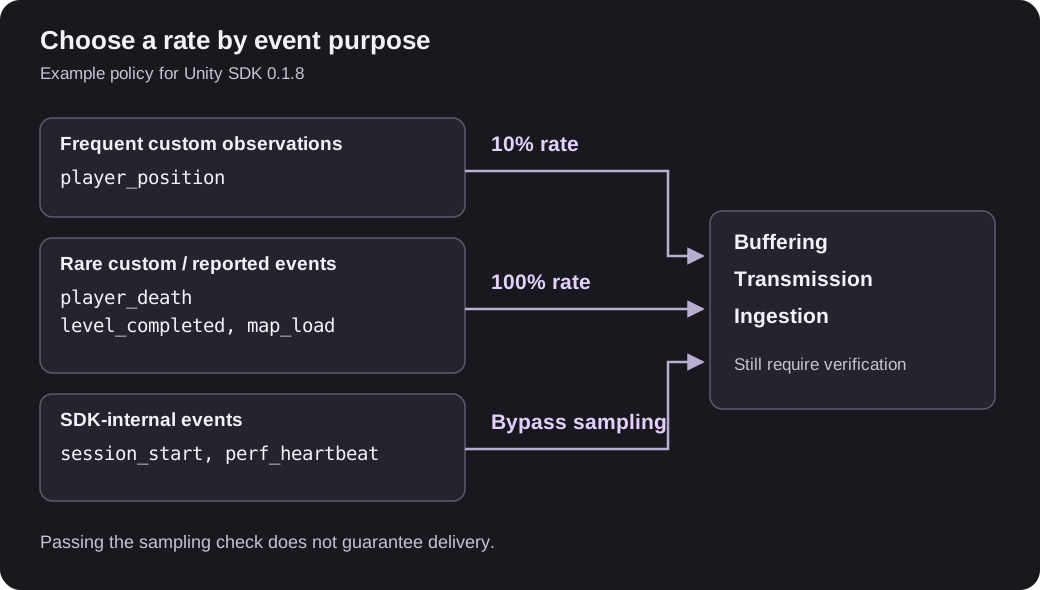
事件记录实现区分了以下路径:
- SDK 内部的
session_start和perf_heartbeat绕过事件采样 - 自定义
Track(...)调用使用事件级保留率;没有覆盖值时使用全局值 EndMapLoad()或ReportMapLoad(...)生成的map_load经过Track(...),因此仍受采样策略影响
这里的“自动”指 SDK 内部的记录路径。BeginAutomatedSession(...) 添加会话元数据,不会让自定义事件绕过采样。即使在自定义 Track 调用中使用内部事件的同名字符串,也不会切换到内部路径。
保留率为 1.0 表示有效调用不会被采样判断排除,并不保证送达。初始化、输入校验、缓冲区容量、退出处理,以及网络或摄取失败,都需要另行检查。绕过采样的 SDK 事件也有这些限制。
采样只能省去判断之后的工作。该 SDK 的 Track 会先做采样判断,再准备可序列化的属性并收集事件的性能快照。但游戏在调用 Track 之前分配的字典或执行的计算已经发生。如果这些工作开销较大,还要调整调用频率和负载准备方式。
保留计数与比率的原始含义
采样后的事件数表示保留下来的观测数。如果已知固定保留率为 0.1,最终保留了 600 条,那么在随机采样模型成立且没有其他丢失的前提下,600 / 0.1 可以估计原始调用数为 6,000。它无法恢复缺失的时间戳、位置或会话历史。
把采样策略与构建或测试配置一同记录。如果运行期间更改采样率,应在自己的埋点记录中保留足够的信息,以区分不同时间段。未知比例的多种采样率不能用一个系数校正,也不要假定现有仪表盘会自动按保留概率的倒数加权。
计算比率时,事件定义和统计人群必须一致。例如,计算每次尝试的通关率时,应一起定义尝试开始和通关事件;数据量允许的话,两者都不采样。用未采样的通关次数除以采样后的位置记录数,得不到通关率。即便两种事件都设为 1.0,解读结果前仍要检查重复调用和未送达事件。
逐事件采样还会打断事件序列。保留了通关却没有保留开始事件,不代表玩家跳过了开始步骤。不要用稀疏采样的数据重建完整漏斗或单个玩家的移动路线。
用已知调用次数的场景验证
在广泛使用策略之前,先进行一次开发测试:
- 单独统计场景实际发起的自定义调用次数,与后端收到的数量分开
- 检查低频事件是否只在预期状态切换时触发一次,包括重试与重新开始的路径
- 暂时把高频测试事件的保留率设为 0,再设为 1,核对行为变化;SDK 内部事件不计入这组测试数量
- 恢复计划使用的采样率,重复足够多次调用,观察数量是否围绕预期值波动,而不要求每个会话都恰好达到该百分比
- 按照 SDK 的刷新与诊断说明,单独检查缓冲处理与退出时的传输
在同一次埋点评审中记录调用间隔、各事件保留率以及事件要回答的问题。下一位开发者添加事件时,应能在复制附近的 Track 调用之前,判断这种数据是否允许缺失。